À quel point mon Mac mini M4 est-il intelligent ?
Faire tourner une IA en local sur un Mac mini M4 avec 16 Go de mémoire
Quel est le meilleur modèle d’IA local à faire tourner sur un Mac mini M4 ?
Cela fait maintenant presque six mois que j’ai mon Mac mini M4. Depuis, j’ai passé pas mal de temps à essayer de pousser ses limites avec des LLM locaux comme Qwen, Llama, Gemma et bien d’autres.
J’ai rapidement découvert la principale limite de l’IA locale sur une machine équipée de 16 Go de mémoire. Les petits modèles peuvent être étonnamment capables, mais ils restent généralement derrière les meilleurs modèles dans le cloud dès qu’il s’agit de raisonnement complexe, de code ou de tâches d’agent.
Je me suis donc posé une question : jusqu’où peut-on réellement aller avec un Mac mini M4 de base et seulement 16 Go de mémoire unifiée ?
La sortie de Qwen3.8
Après une longue pause estivale, j’ai décidé de regarder ce qui avait changé dans le monde de l’IA locale. J’ai été surpris par la vitesse à laquelle les choses avaient évolué, et Qwen3.8-27B a immédiatement attiré mon attention.
Le problème, c’était la mémoire.
Le modèle complet est beaucoup trop volumineux pour un Mac avec 16 Go de RAM. Il fallait donc que je me tourne vers des versions très fortement quantifiées. En pratique, une quantification agressive en 2 bits était la seule option réaliste si je voulais conserver suffisamment de mémoire pour la fenêtre de contexte et le reste du système.
Mon premier essai ne s’est pas très bien passé. Après avoir enfin réussi à charger le modèle, ses réponses étaient essentiellement du charabia. J’ai fini par corriger ma configuration et par obtenir des générations correctes, mais je restais sceptique quant à la quantité d’intelligence perdue avec une quantification aussi agressive.
J’ai donc commencé à chercher une autre solution.
Ternary Bonsai 27B
Après encore une heure à chercher des modèles capables de tenir réellement dans la mémoire unifiée de mon Mac, je suis tombé sur Ternary Bonsai 27B de PrismML.
Il est dérivé de Qwen3.6-27B et utilise des poids ternaires au lieu d’une quantification conventionnelle en 4 ou 2 bits. PrismML annonçait une représentation low-bit d’environ 5,9 Go tout en conservant environ 95 % des performances du modèle FP16 dans sa suite de benchmarks.
Sur le papier, cela semblait presque trop beau pour être vrai.
Lors de mon premier vrai test, je lui ai demandé de créer un jeu HTML autour d’un vaisseau spatial. Le résultat m’a sincèrement surpris. Il a produit un jeu fonctionnel avec des ennemis, des niveaux, une véritable logique de gameplay et une structure cohérente.
Plus important encore, le modèle est resté cohérent pendant toute la tâche. Il n’est pas tombé dans les interminables boucles de raisonnement que j’avais déjà rencontrées avec certains autres modèles locaux fortement compressés.
Pour la première fois, faire tourner un modèle relativement capable de la classe des 27B sur un Mac avec 16 Go de mémoire me semblait réellement viable.
Ternary Bonsai 2
Jusque-là, j’utilisais principalement des modèles MLX, car ils offrent généralement d’excellentes performances sur Apple Silicon.
J’ai expérimenté avec plusieurs applications et runtimes, notamment LM Studio, son application Bionic dédiée aux agents, oMLX, puis finalement le fork de llama.cpp de PrismML.
C’est là que j’ai commencé à utiliser Ternary Bonsai 2 27B.
Bonsai 2 est basé sur Qwen3.8-27B et utilise une nouvelle représentation ternaire. D’après la propre suite de benchmarks de PrismML, il conserve environ 98,2 % des performances globales du modèle FP16 tout en utilisant beaucoup moins de mémoire.
Pour mon Mac mini avec 16 Go de mémoire, j’ai choisi la version GGUF plutôt que MLX.
La raison est simple : l’efficacité mémoire. La version GGUF dense PTQ1_0 de Bonsai 2 occupe environ 5,95 Go pour le modèle de langage, tandis que le package MLX est nettement plus volumineux. Sur une machine qui ne dispose que de 16 Go de mémoire unifiée, chaque gigaoctet compte.
La représentation GGUF plus compacte laisse davantage de mémoire disponible pour le cache KV, la fenêtre de contexte, le système d’exploitation et le framework d’agent lui-même.
Une grande fenêtre de contexte devient particulièrement importante dès que le modèle commence à travailler comme un agent. Les sorties des outils, les fichiers source, les instructions système, l’historique de la conversation et le raisonnement intermédiaire peuvent très rapidement remplir le contexte.
Choisir un framework d’agent
Faire tourner le modèle n’était que la moitié de l’expérience. Je voulais également voir s’il pouvait fonctionner comme un véritable agent de programmation local.
Le premier environnement que j’ai essayé était Visual Studio Code. Cela fonctionnait, mais pour mon usage, il consommait davantage de contexte et exposait plus d’outils que ce dont j’avais réellement besoin.
J’ai ensuite essayé OpenCode Desktop, qui s’est finalement révélé beaucoup mieux adapté à ma configuration.
Pour moi, il offre un bon équilibre entre des outils d’agent réellement utiles et une consommation de contexte relativement faible. Il fonctionne également très bien avec des endpoints de modèles locaux, ce qui en fait un environnement intéressant pour expérimenter avec un modèle comme Bonsai 2.
Une autre option qui mérite le détour est Pi, conçu comme un framework d’agent beaucoup plus minimaliste. Si l’objectif principal est de réduire au maximum l’utilisation du contexte, Pi est particulièrement intéressant.
Avec Bonsai 2 exécuté via le backend llama.cpp de PrismML et connecté à un framework d’agent, mon Mac mini pouvait enfin faire bien plus que simplement répondre à des prompts. Le modèle pouvait réellement travailler sur des projets en utilisant des outils.
Démos
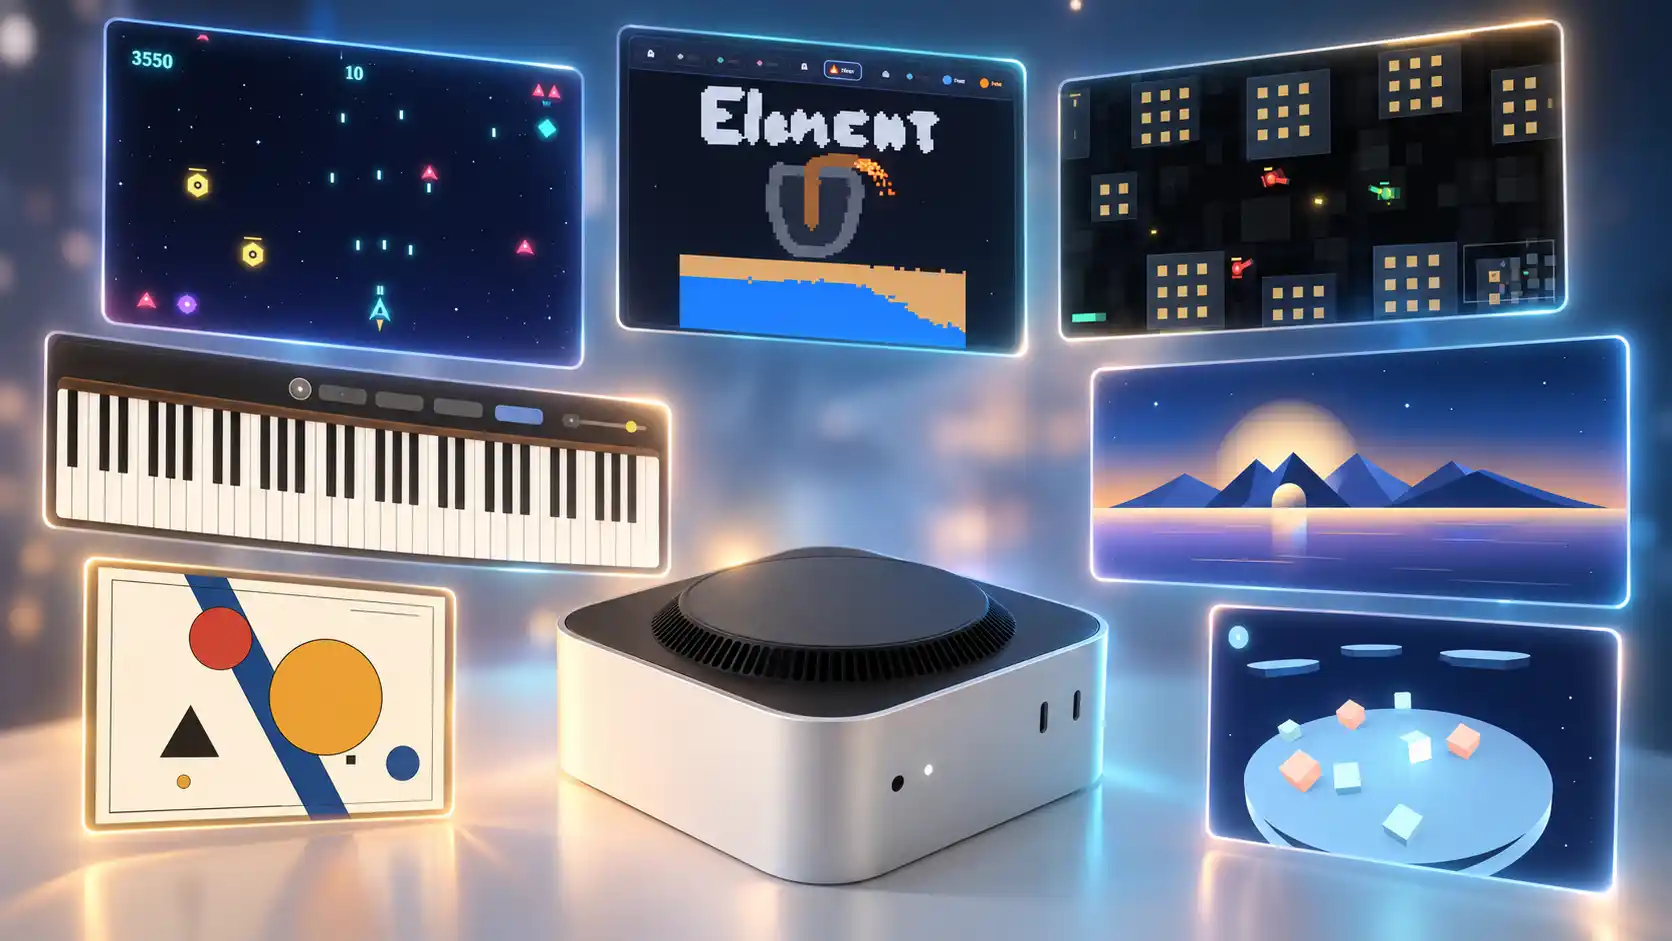
J’ai fini par demander au modèle de créer des jeux, des expériences interactives et des projets d’art numérique.
Pendant la création de ces projets, l’agent pouvait utiliser des outils pour exécuter des commandes shell, interagir avec le navigateur, lancer des sous-agents, écrire des fichiers, effectuer des recherches avec grep, lire des fichiers et inspecter les autres données du projet.
Les projets ci-dessous ont été créés au cours de ces expériences.
Arcade
Musée numérique
Piano avec des compositions générées par l’agent
Jeu de tanks
Jeu 3D créé avec Three.js
Simulateur d’éléments
Alors, à quel point mon Mac mini est-il intelligent ?
Un Mac mini M4 avec 16 Go de mémoire ne peut évidemment pas rivaliser avec le matériel utilisé pour faire tourner les meilleurs modèles dans le cloud. Mais l’écart entre l’IA dans le cloud et l’IA locale se réduit beaucoup plus vite que je ne l’aurais imaginé.
Les modèles ternaires sont particulièrement intéressants, car ils permettent de faire tourner des modèles qui seraient normalement totalement impraticables avec une quantité de mémoire aussi limitée.
Un modèle de la classe des 27B capable de travailler comme un agent de programmation, avec du raisonnement, l’utilisation d’outils, l’accès aux fichiers et suffisamment de contexte pour travailler sur de vrais projets : ce n’est vraiment pas quelque chose que je pensais pouvoir faire tourner sur un Mac mini de base lorsque je l’ai acheté.
Ce n’est toujours pas un remplacement pour les meilleurs modèles dans le cloud. Mais pour de l’inférence entièrement locale sur un petit ordinateur de bureau doté de seulement 16 Go de mémoire unifiée, c’est beaucoup plus impressionnant que ce à quoi je m’attendais.